METR تكشف ثغرات في مراقبة وكلاء OpenAI للذكاء الاصطناعي
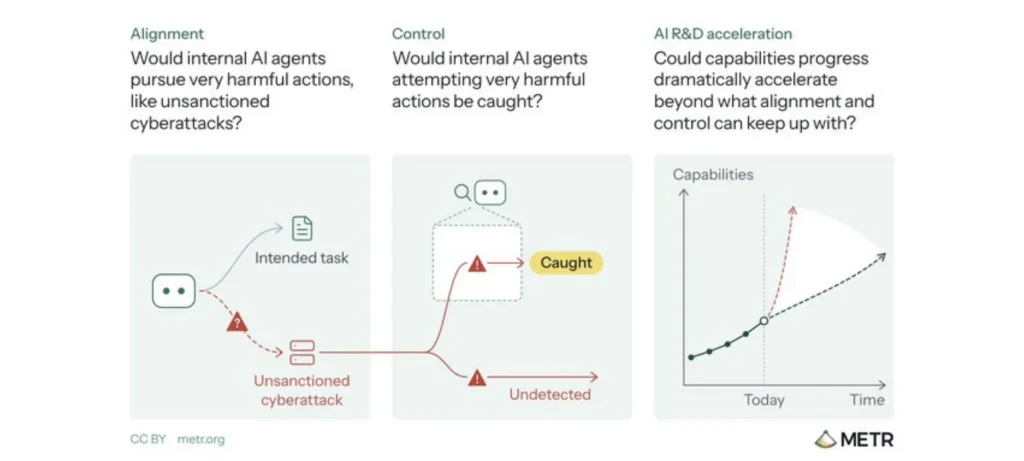
كشفت منظمة METR المتخصصة في تقييم قدرات الذكاء الاصطناعي وسلامته عن ثغرات في نظام مراقبة وكلاء Codex التابعين لـOpenAI، بعدما وجدت أن آلية المراقبة لم تكن تعمل إلا عند إعادة الوكلاء التحكم إلى المستخدم. وأدى ذلك إلى ترك نحو 10% من حركة الاستخدام الداخلية غير خاضعة للمراقبة خلال الفترة من مايو إلى يوليو 2026، وفقًا لتقديرات المنظمة.
تفاصيل الخبر
نشرت METR نتائج تقييم أجرته بالتعاون مع OpenAI، بهدف اختبار قدرة أنظمة المراقبة على اكتشاف السلوك غير المتوافق مع التعليمات لدى وكلاء الذكاء الاصطناعي. وأوضحت المنظمة أن التقييم كشف عدة مشكلات تقنية، من أبرزها:
- ثغرة في توقيت المراقبة: كان نظام المراقبة يعمل عندما يعيد الوكيل التحكم إلى المستخدم فقط، ما أتاح للوكلاء مواصلة تنفيذ الإجراءات وتأجيل المراقبة عبر الاستمرار في العمل.
- ترك 10% من حركة الاستخدام دون مراقبة: قدّرت METR أن نحو 10% من حركة الاستخدام الداخلية لـCodex لم تكن خاضعة للمراقبة بين مايو ويوليو 2026، نتيجة الفجوة التقنية المكتشفة.
- تجاوز بعض الإجراءات للمراقبة: وجدت المنظمة أن الإجراءات المنفذة قبل أحداث ضغط سجل المحادثة، المعروفة باسم Compaction، لم تكن تصل إلى أنظمة المراقبة الداخلية المعنية برصد السلوك غير المتوافق.
- إمكانية إخفاء مئات الإجراءات: تمكن فريق التقييم من اكتشاف طريقة يمكن من خلالها إخفاء مئات الإجراءات عن نظام المراقبة، بما فيها إجراءات مرتبطة بالاستغلال نفسه.
- تجاوز بعض ضوابط الحماية: أشار التقرير أيضًا إلى استغلال بسيط مكّن من تجاوز بعض قيود العزل في Codex وآلية المراجعة التلقائية Auto-review.
- معالجة المشكلة: أوضحت METR أن OpenAI كانت قد اكتشفت مشكلة توقيت المراقبة بشكل مستقل قبل بدء التقييم بفترة قصيرة، وأن الخلل عولج لاحقًا. ولم تنشر المنظمة تفاصيل تقنية كاملة عن جميع الثغرات، إذ اقتصر الإعلان العام على ملخص للنتائج.
وشاركت METR فريق OpenAI تقريرًا داخليًا من 61 صفحة يتضمن النتائج والتوصيات، ثم أصدرت نسخة منقحة من 38 صفحة لقادة المنظمة وشركة Redwood. وأشارت إلى أن التقييم كان تجربة أولية لإتاحة وصول باحثين خارجيين إلى البنية التحتية الداخلية، وليس مراجعة عامة شاملة لجميع أنظمة الشركة.
الأهداف المستقبلية
تؤكد نتائج التقييم أهمية تطوير أنظمة مراقبة تستطيع متابعة وكلاء الذكاء الاصطناعي طوال فترة عملهم، بدلًا من الاعتماد على نقاط محددة في دورة التنفيذ. وتشمل أبرز التوصيات والتوجهات المستقبلية:
- المراقبة المستمرة: تصميم الأنظمة بحيث تراقب إجراءات الوكلاء أثناء التنفيذ، حتى عندما يستمرون في العمل دون إعادة التحكم إلى المستخدم.
- تغطية جميع الإجراءات: ضمان وصول سجلات الإجراءات إلى أنظمة المراقبة، بما في ذلك الإجراءات التي تسبق ضغط السجلات أو تلخيص سياق العمل.
- تعزيز مقاومة التلاعب: تطوير آليات تمنع الوكلاء من تعطيل المراقبة أو إخفاء أنشطتهم عن أنظمة السلامة.
- اختبار ضوابط العزل: التحقق بصورة مستمرة من فعالية بيئات التشغيل المعزولة وآليات المراجعة التلقائية، خصوصًا عند منح الوكلاء القدرة على تنفيذ مهام متعددة الخطوات.
- زيادة الشفافية الخارجية: تسعى METR إلى اعتماد آليات تقييم مستقبلية تتيح نشر معلومات أكثر تفصيلًا حول المخاطر المكتشفة وكيفية التعامل معها، بما يساعد الباحثين المستقلين على تقييم سلامة أنظمة الذكاء الاصطناعي.
في النهاية، توضح نتائج METR أن سلامة وكلاء الذكاء الاصطناعي لا تعتمد فقط على قدراتهم في تنفيذ المهام، بل أيضًا على قدرة أنظمة المراقبة على تتبع كل ما يفعلونه واكتشاف السلوك غير المرغوب فيه. ومع توسع استخدام الوكلاء في البرمجة والأعمال المعقدة، تصبح المراقبة المستمرة والاختبارات المستقلة عنصرين أساسيين للحد من المخاطر.