

CData: كيف تخفض طبقة البيانات تكلفة الذكاء الاصطناعي 178 مرة
أظهر تقرير CData أن اختيار نموذج الذكاء الاصطناعي لا يعني بالضرورة التضحية بالدقة عند خفض التكلفة، إذ تمكنت نماذج مختلفة من تقديم الإجابة الصحيحة نفسها عند استخدام طبقة بيانات مناسبة، مع فارق وصل إلى 178 مرة في التكلفة.
تفاصيل الخبر
أجرت CData اختبارًا شمل 22 نموذجًا للذكاء الاصطناعي عبر 1,034 تجربة باستخدام بيانات حية من أنظمة CRM ومستودعات البيانات وأنظمة إدارة خدمات تقنية المعلومات (ITSM). وركز الاختبار على معرفة ما إذا كانت طبقة البيانات تستطيع الحفاظ على الدقة والسلامة، مع السماح باستخدام نماذج أقل تكلفة.
وأظهرت النتائج أن وجود طبقة البيانات CData Connect AI غيّر طريقة تقييم تكلفة النماذج، إذ أصبحت النماذج قادرة على الوصول إلى البيانات وفهم قواعد العمل المحددة بدل الاعتماد على تخمينها.
ومن أبرز نتائج الاختبار:
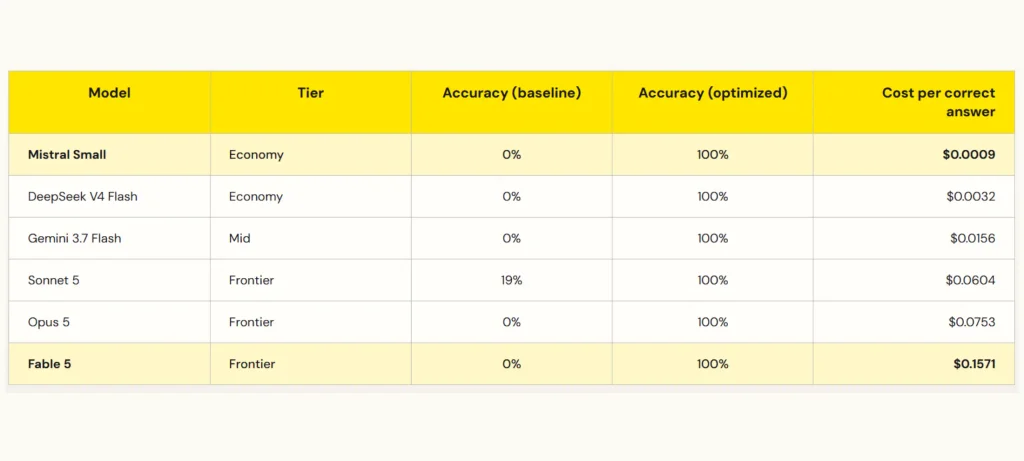
- وصلت دقة النماذج إلى 100% في الاختبارات المحسّنة، بدءًا من النماذج الاقتصادية وصولًا إلى نماذج Frontier.
- تراوحت تكلفة الإجابة الصحيحة بين 0.0009 دولار و0.1571 دولار.
- بلغ الفارق بين أرخص وأغلى نموذج نحو 178 مرة في إحدى مهام الاختبار.
- في مهام القراءة، تراوحت تكلفة النماذج التي حققت دقة كاملة بين 178 و278 ضعفًا.
- في مهام الكتابة، تمكن 20 نموذجًا من أصل 22 من تنفيذ العمليات المطلوبة بدقة 100% عند استخدام طبقة البيانات.
- في المقابل، أدى الاعتماد على النماذج وحدها للوصول إلى البيانات الخام إلى أخطاء كبيرة، بما في ذلك كتابة آلاف القيم غير الصحيحة في إحدى التجارب.
- أظهر الاختبار أيضًا أن بعض النماذج قد تقدم إجابات تبدو صحيحة ومنظمة، لكنها في الواقع تستند إلى بيانات أو قواعد عمل غير صحيحة.
وتشير CData إلى أن المشكلة لا ترتبط بقدرة النموذج على الإجابة فقط، بل بالطريقة التي يحصل بها على البيانات والقواعد التي تحكم استخدامها. فعندما تكون قواعد العمل مدمجة في طبقة البيانات، يمكن للنماذج المختلفة الاستفادة منها بصورة أكثر اتساقًا.
الأهداف المستقبلية
تسلط نتائج التقرير الضوء على توجه متزايد نحو فصل منطق الأعمال والبيانات والضوابط الأمنية عن النموذج نفسه، بدل الاعتماد على نموذج واحد لتنفيذ جميع المهام.
ومن أبرز الأهداف المستقبلية التي تبرزها هذه النتائج:
- استخدام نماذج أقل تكلفة عندما تكون قادرة على تحقيق الدقة المطلوبة.
- وضع قواعد العمل في طبقة بيانات مشتركة يمكن للنماذج المختلفة الاستفادة منها.
- تقليل الأخطاء الناتجة عن وصول النماذج إلى البيانات الخام دون سياق كافٍ.
- تحسين اتساق نتائج الذكاء الاصطناعي بين تجربة وأخرى.
- فرض حدود واضحة على عمليات الكتابة والتعديل التي تنفذها النماذج.
- مساعدة الشركات على إدارة تكلفة استخدام الذكاء الاصطناعي دون الاعتماد دائمًا على أغلى النماذج.
- إنشاء بنية تسمح بتغيير النموذج المستخدم دون إعادة بناء منطق البيانات والأعمال من البداية.
وتشير هذه النتائج إلى أن خفض تكلفة الذكاء الاصطناعي قد لا يعتمد فقط على اختيار نموذج أرخص، وإنما أيضًا على بناء طبقة بيانات توفر للنموذج السياق والقواعد والقيود اللازمة لتنفيذ المهمة بصورة صحيحة.
يكشف اختبار CData أن الفارق في أسعار نماذج الذكاء الاصطناعي لا يعكس بالضرورة فارقًا مماثلًا في دقة النتائج عندما تتولى طبقة البيانات تنظيم السياق وقواعد العمل. ومع تطور استخدام الذكاء الاصطناعي داخل الشركات، قد تصبح إدارة البيانات والضوابط جزءًا أساسيًا من تحقيق نتائج دقيقة بتكلفة أقل.


